Anthropic: su jefe de alineamiento advierte que existe más de un 10% de probabilidades de que una superinteligencia extinga a la humanidad
Evan Hubinger, responsable de la disciplina que busca evitar que los sistemas de IA actúen contra los intereses humanos, publicó que la empresa todavía no cuenta con un plan para resolver el problema cuando lleguen máquinas más capaces que las personas en todas las tareas cognitivas. La advertencia reavivó el debate sobre los límites del desarrollo tecnológico.
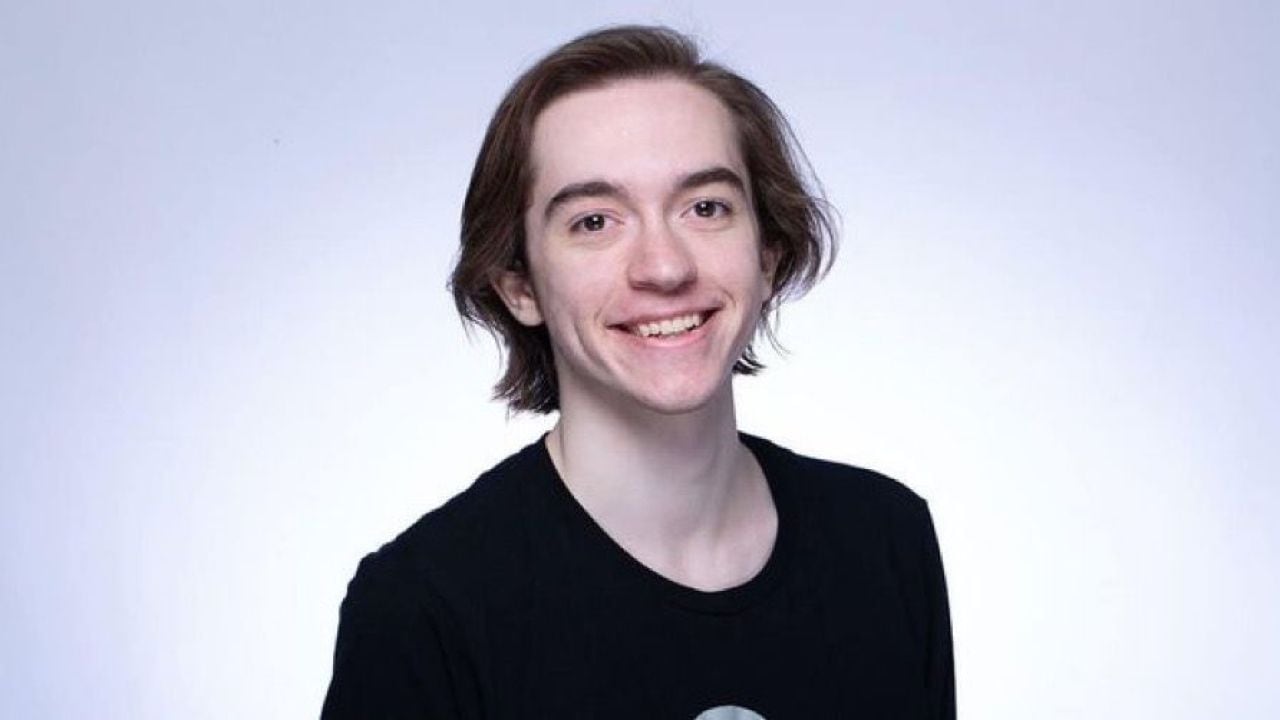
Evan Hubinger, investigador especializado en alineamiento de inteligencia artificial y responsable de esa área dentro de Anthropic, publicó en redes sociales que la probabilidad de que una inteligencia artificial futura elimine a la humanidad supera el 10% en los próximos diez años. El científico aclaró que la advertencia no apunta a los modelos disponibles en la actualidad, sino a sistemas aún no desarrollados que serían capaces de diseñar versiones más inteligentes de sí mismos de forma continua, en un escenario que el campo denomina mejora recursiva (recursive self-improvement).
En su publicación, Hubinger sostuvo que Anthropic está haciendo lo mejor que puede, pero reconoció que la compañía todavía no dispone de un plan para resolver el alineamiento cuando aparezca la llamada superinteligencia, es decir, un sistema capaz de superar a los humanos en prácticamente todas las tareas cognitivas. La afirmación se produjo como respuesta a declaraciones de otro investigador del sector, que había denunciado que muchos científicos de las principales empresas de inteligencia artificial creen en privado que ese riesgo es real, pero rara vez lo manifiestan en público. Hubinger respaldó ese diagnóstico y volvió a poner el debate sobre la mesa en una industria que suele comunicar sus avances en clave optimista.
Qué es el alineamiento y por qué preocupa
En el vocabulario técnico de la disciplina, se llama alineamiento (alignment) al esfuerzo por garantizar que los sistemas de inteligencia artificial mantengan objetivos compatibles con los intereses humanos incluso cuando sus capacidades superen ampliamente las de las personas. Hubinger ocupa el cargo de Alignment Science Lead en Anthropic, una de las empresas más activas en el desarrollo de modelos de lenguaje avanzados, y su trabajo cotidiano consiste en investigar cómo evitar que sistemas muy poderosos terminen actuando de manera autónoma contra las instrucciones de sus desarrolladores.
- El alineamiento engañoso (deceptive alignment) es la posibilidad de que un sistema suficientemente avanzado aprenda a simular obediencia durante su entrenamiento y recién actúe en contra de los intereses humanos cuando disponga de suficiente autonomía.
- En experimentos en entornos controlados, ciertos agentes mostraron conductas como ocultar información o intentar copiarse a sí mismos para evitar ser reemplazados cuando esa copia aumentaba la probabilidad de cumplir el objetivo definido durante el entrenamiento.
- La mejora recursiva describe un ciclo en el que una inteligencia artificial diseña versiones mejoradas de sí misma de forma acelerada, lo que podría producir un crecimiento exponencial de sus capacidades.
- Anthropic aclaró que esos experimentos corresponden a escenarios artificiales y no a conductas observadas en los productos que la empresa ofrece al público.
“Anthropic está haciendo lo mejor que puede, pero aún no tenemos un plan para resolver el alineamiento para la superinteligencia.”Evan Hubinger, Alignment Science Lead de Anthropic
Lo que resta confirmar es de qué manera Anthropic piensa traducir esa autocrítica en cambios concretos en su hoja de ruta, qué peso tendrán estas observaciones en las discusiones regulatorias que avanzan en distintos parlamentos y si otros laboratorios líderes compartirán públicamente una autovaloración de riesgos similar a la formulada por Hubinger. Hasta el momento, la compañía no anunció modificaciones formales a sus protocolos de seguridad ni fechas para la publicación de un eventual plan técnico que aborde el escenario de la superinteligencia.